まず、フェンシング機能を備えたサポート対象のSLES 15 HAクラスタを構築します。

SLE HAを登録し、SLES 15ノードをブートストラップした後、フェンシング、クォーラム、およびテスト済みのサービスリソースを追加してから、フェイルオーバーに頼るようにしてください。
SLES 15 の場合、SUSE Linux Enterprise High Availability 拡張機能を登録し、その後crm cluster init、コマンドを使用してcrm cluster joinノードをブートストラップします。クラスタにサービスを配置する前に、冗長ネットワーク、ノードフェンシング (STONITH)、およびクォーラムを確認してください。
この手順は、2026年10月時点のSLE HA 15 SP7のドキュメントに準拠しています。インストールされているサービスパックとCPUアーキテクチャを確認してください。登録識別子とサポートの詳細は異なる場合があります。
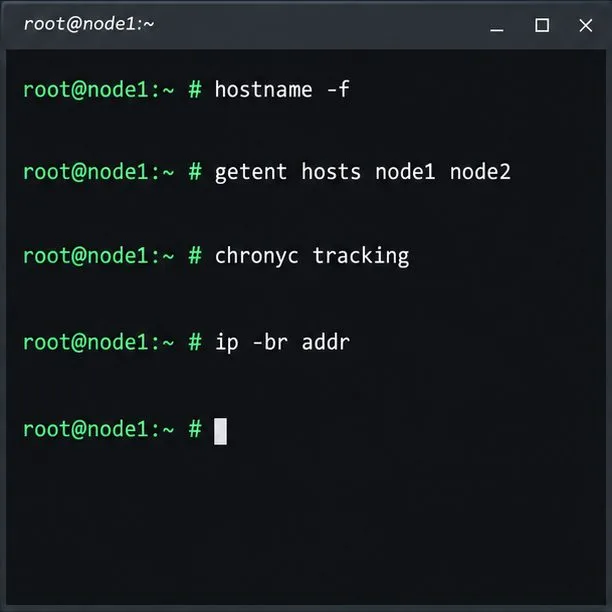
同じサポート対象のプロセッサアーキテクチャ上で少なくとも2つのノードを使用し、静的プライマリIPアドレス、各ノードで解決可能な一意の名前、および外部タイムソースを使用した同期クロックを使用してください。SUSEでは、ノードごとに2つの冗長なTCP/IP通信パスが必要であり、インターフェース名はノード間で一致している必要があります。
hostname -f
getent hosts node1 node2
chronyc tracking
ip -br addr
ブートストラップを実行する前に、両方のノードでチェックを実行し、選択したインターフェースと名前が正しいことを確認してください。
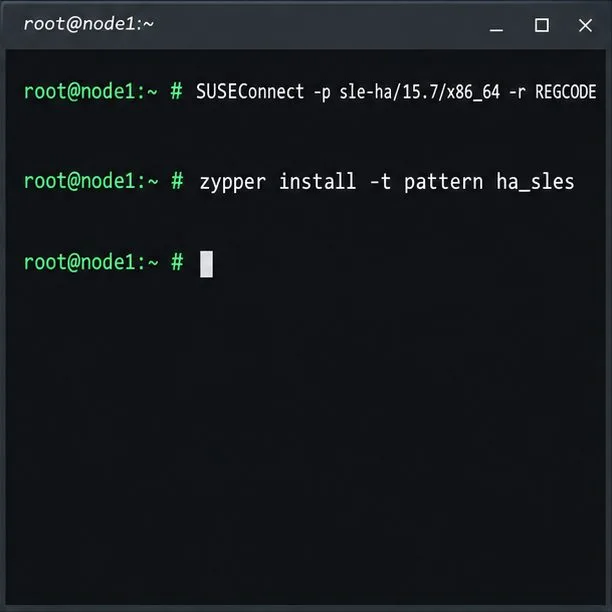
SLE HAは別途登録が必要な拡張機能であり、SLES単体ではクラスタパターンは含まれていません。登録済みのSLES 15 SP7 x86_64ノードでは、拡張機能を有効にし、各ノードにパターンをインストールしてください。
SUSEConnect -p sle-ha/15.7/x86_64 -r ADDITIONAL_REGCODE
zypper install -t pattern ha_slesサブスクリプションコードに置き換えてくださいADDITIONAL_REGCODE。製品識別子は x86_64 用です。他のアーキテクチャの場合は、SUSE の対応する識別子を使用してください。すべてのノードを同じ SLES SP および SLE HA レベルに維持してください。SUSEの SLE HA 15 SP7 インストール ガイドを参照してください。
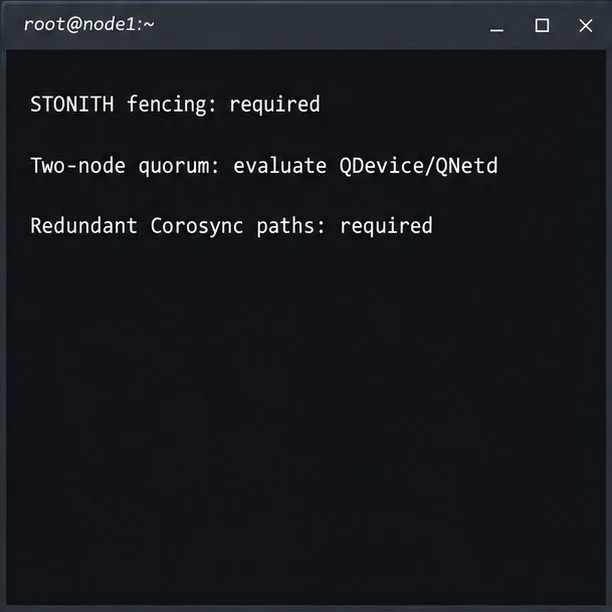
サポートされているクラスターに必要な機能:ノードフェンシング(STONITH)を有効にし、 trueのstonith-enabledままstartup-fencingにします。フェンシングは、不確かなノードを隔離して、パーティションの両側で同じサービスが実行されないようにします。ハードウェアまたはハイパーバイザーには、サポートされている電源制御デバイス、またはテスト済みのウォッチドッグを備えたSBDを選択してください。
2ノード構成の場合: SUSEは、偶数ノード構成のクラスタにはQDevice/QNetdの使用を推奨しています。QDevice/QNetdは、フェンシングではなく独立したクォーラム投票機能を追加します。ブートストラップ時にQDeviceを含める場合は、まず個別のQNetdサーバーを設定してください。詳細は「QDeviceおよびQNetdガイド」を参照してください。
ストレージに関する誤解:共有ストレージはすべてのクラスタに必須ではありませんが、アプリケーションデータには独自の共有、複製、または復旧可能な設計が必要です。Pacemakerはリソースを移動しますが、アプリケーションデータをコピーするわけではありません。
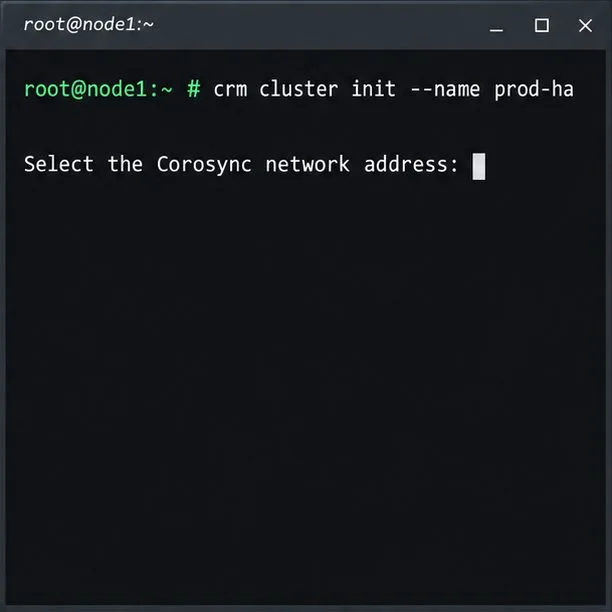
node1上で、root権限で、または承認済みのsudoユーザー設定を使用してCRMシェルブートストラップを開始します。
crm cluster init --name prod-ha画面の指示に従って、目的のCorosyncアドレスを選択してください。このスクリプトは、Corosync、SSH、Csync2、クラスタファイアウォールポート、およびHawk2を設定し、時刻同期をチェックします。また、オプションでSBDとHawk2管理IPアドレスを提供します。/var/log/crmsh/crmsh.logブートストラップ設定を確認してください。
SBDを選択する前に、各ノードでウォッチドッグを設定してください。外部フェンシングを使用する場合は、ワークロードの前に、サポートされているSTONITHリソースを設定してください。デバイスが見つからない場合でも、STONITHを無効にしてバイパスしないでください。ブートストラップは基本的なクラスタを作成するものであり、HAアプリケーションを作成するものではありません。
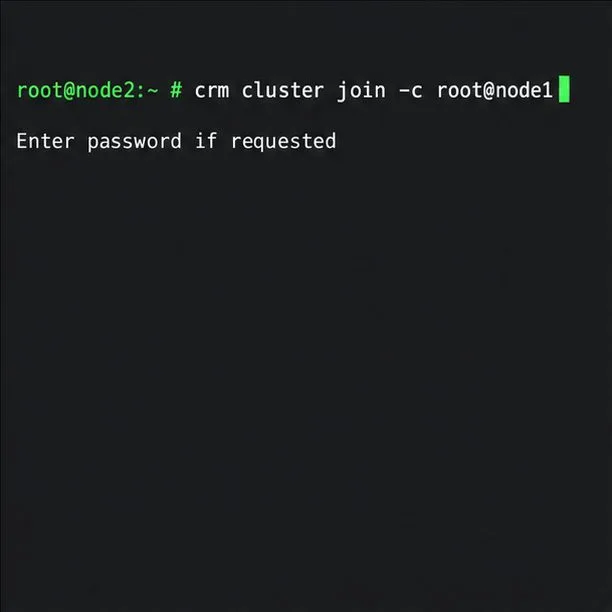
node2にSLE HAをインストールして登録します。SBDを使用する場合は、参加する前にウォッチドッグを準備してください。次に、rootとして以下の操作を行います。
crm cluster join -c root@node1sudoユーザーを設定する場合は、SUSEのUSER@NODE1手順に従ってください。初期化時に設定した場合は、同じ2つのインターフェースを指定してください。このスクリプトは、Corosyncの設定をコピーし、SSHとCsync2をセットアップして、node2をオンラインにします。ノード数を増やす場合は、この手順を繰り返してください。ブートストラップとYaSTのセットアップ方法を混在させないでください。
クラスタノードからメンバーシップを確認します。
crm status両方のノードがオンラインであり、クォーラムが存在することを確認してください。ブートストラップはhacluster初期パスワードで作成されますlinux。初期化された各ノードでパスワードを変更してください。
passwd haclusterHawk2はポートでHTTPSを使用します7630。自己署名証明書を信頼する前に、管理者に確認してもらってください。Hawk2の管理IPアドレスは、アプリケーションのクライアントアドレスではありません。
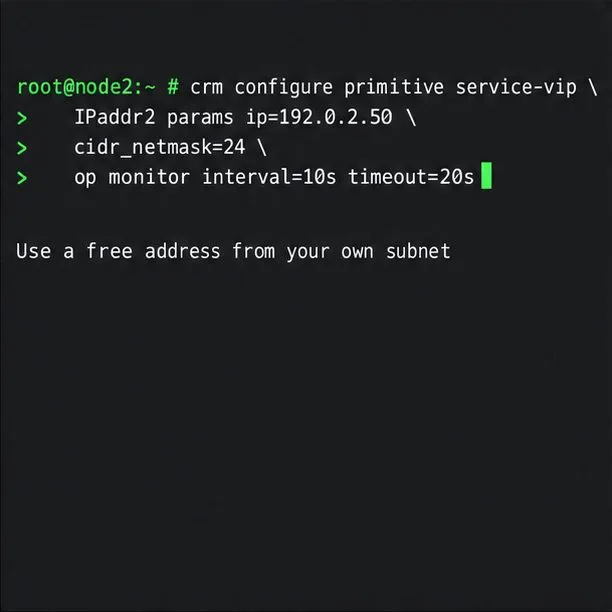
Pacemakerはリソースエージェントを介してサービスを管理します。対象となるノードにワークロードを適切にインストールおよび構成してください。この例では、フローティングIPプリミティブのみを作成します。
crm configure primitive service-vip IPaddr2 params ip=192.0.2.50 cidr_netmask=24 op monitor interval=10s timeout=20s192.0.2.50はドキュメント用に予約されています。サブネットから空いているアドレスと正しいプレフィックスを指定してください。IPプリミティブはアプリケーションを起動したり、データを複製したりするものではありません。アプリケーションがサポートするエージェントと、ワークロード固有の順序付け、コロケーション、ストレージ動作を追加し、その製品のリカバリとフェンシングに関するガイダンスに従ってください。
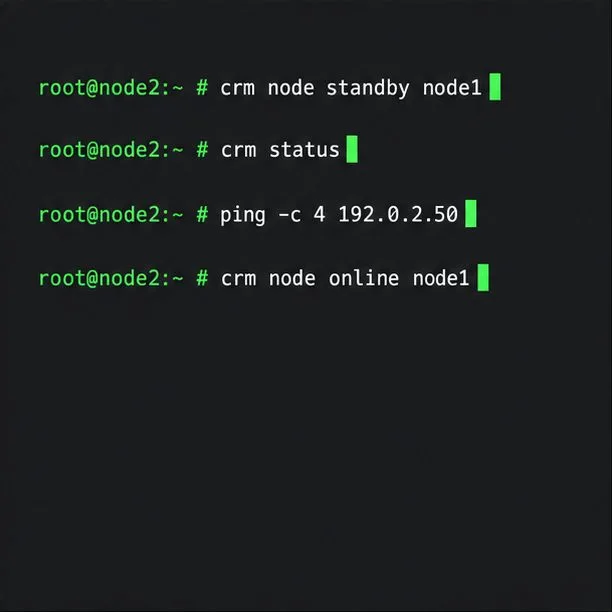
実際のリソースとフェンシングを設定した後、制御されたフェイルオーバーテストをスケジュールします。ノード1をスタンバイ状態にし、ノード2からサービスを確認します。
crm node standby node1
crm status
ping -c 4 SERVICE_VIP
crm node online node1
実際のクライアント アドレスに置き換えてくださいSERVICE_VIP。アプリケーションが応答し、リソースが想定どおりに移動し、node1 が再参加することを確認してください。ping はネットワークの到達可能性のみをチェックします。SUSE の機能は意図的にコンポーネントを中断するため、計画されたテスト環境で使用してください。SLE HA インストール クイック スタートおよびフェンシング ガイドをcrm cluster crash_testお読みください。
テスト後、両方のノードが期待どおりの状態であること、フェンシングが有効になっていること、およびノード1がオンラインに戻った後にワークロードがクライアントエンドポイント経由で応答することを確認してください。メンバーシップビューが緑色であること、またはpingが成功したことだけでは、アプリケーションの復旧を証明するものではありません。
SLE HAを登録し、SLES 15ノードをブートストラップした後、フェンシング、クォーラム、およびテスト済みのサービスリソースを追加してから、フェイルオーバーに頼るようにしてください。
Zypperの更新エラーの原因をSUSE、RMT、またはサードパーティのエンドポイントに特定し、重要なアップデートを無効にすることなく、適切なサーバー側またはキャッシュの修正を適用してください。
SUSE LVM シンプールのスペースエラーを解決するには、データとメタデータの使用状況を確認し、プールを安全に拡張し、障害の再発を防ぎます。
Btrfsが意図的に読み取り専用になっているのか、容量不足なのか、エラー発生後のデータ保護のために動作しているのかを特定し、その原因に合った復旧方法を選択してください。
ミラーリングされたチャネルを準備し、アクティベーションキーを作成し、マネージャーのチェックインに必要な接続を維持しながら、インターネットに直接アクセスできないSLES 15クライアントをブートストラップします。
YaSTのSSH経由のXIO起動エラーを修正し、X11転送とxauthを検証し、リモートウィンドウが不要な場合はncursesインターフェースに切り替えます。
アップデート前のBtrfsスナップショットを見つけて、読み取り専用でテストし、どのデータがルートロールバックの対象外になるかを理解した上で、Snapperを使用して永続的なリカバリを実行します。
SLESシステムのログを、認証済みTLS経由でリモートのrsyslogコレクターに送信します。この際、証明書のチェック、障害発生時のバッファリング、および配信テストが行われます。
RAM、スワップ、カーネル、およびZypperのログを使用して、実際のメモリ負荷を特定し、パッケージの状態を保護し、より安全なSLESアップグレードの再試行を選択します。
DebianのSSH経由の自動セキュリティアップデートを有効にし、デフォルトのパッケージソースを維持し、systemdとAPTのログを通じてスケジュールされた実行を確認します。








