CCUSの規模拡大:二酸化炭素回収は本当に世界の排出量を逆転させることができるのか?

CCUS(二酸化炭素回収・利用・貯留)への投資は増加しているが、二酸化炭素回収は世界の排出量を逆転させることができるのだろうか?その有効性、規模拡大の制約要因、そして重要な証拠について見ていこう。
2026年9月16日現在、Herokuの公開ステータスAPIのスナップショットでは、アプリ、データ、ツールが緑色で、アクティブなインシデントは表示されていませんでした。これはあくまである時点でのチェックであり、すべてのアプリ、リージョン、依存関係が正常であることを保証するものではありません。Herokuは現在、Salesforce TrustのHerokuステータスページをインシデントおよびメンテナンスに関する主要な連絡チャネルとして指定していますが、従来のステータスAPIは、プログラムによる迅速なスナップショット取得に引き続き役立ちます。
障害発生の背景には、プラットフォームレベルでの重要な進展もあります。Herokuは2026年2月6日のアップデートで、安定性、セキュリティ、信頼性、サポートに重点を置いた維持エンジニアリングモデルに移行したと発表しました。Herokuは、プラットフォームは積極的にサポートされ、本番環境に対応できる状態にあると説明し、既存のクレジットカード利用者は料金、請求、サービス、日常的な利用状況に変更はないと述べています。この発表はライフサイクルと投資に関するアップデートであり、展開済みのアプリケーションが停止されるという声明ではありません。
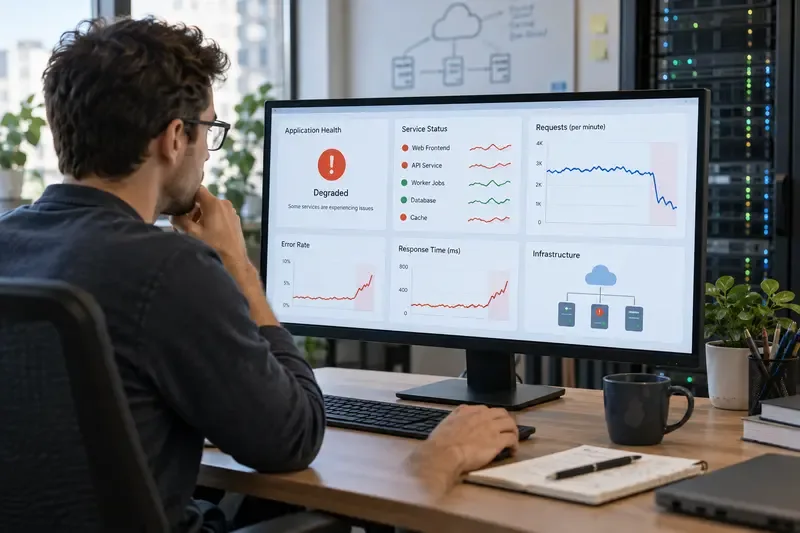
「Herokuの障害」は、単一の障害モードではありません。Heroku独自のサービスカテゴリでは、プラットフォームはアプリ、データ、ツールに分けられています。実際の影響は、どのレイヤーが障害を起こしているか、そしてそのレイヤーがなくてもアプリケーションが継続できるかどうかによって異なります。
| サービスレイヤー | 何が失敗する可能性があるか | ユーザーが気づくかもしれないこと | 最優先事項 |
|---|---|---|---|
| アプリ | Dyno、ルーティング、またはスケジュールされたアプリケーション作業 | タイムアウト、5xx応答、ページングの遅延、またはジョブの失敗 | 公開アプリをテストし、ウェブトラフィックとバックグラウンド処理を分離する |
| データ | Heroku Postgres、Heroku Key-Value Store、Apache Kafka、またはHeroku Connect | 読み取り/書き込みの失敗、古いレコード、キューの遅延、または同期のずれ | データ整合性を保護し、再試行回数を制御する |
| ツール | Gitプッシュによるデプロイ、Deployment API、GitHub統合、ログ記録、またはテレメトリ | デプロイが失敗する、ログが利用できない、またはダッシュボードが現実を反映していない | 繰り返しリリースを避け、独立した監視を使用する |
| 外部依存関係 | Salesforce API、決済プロバイダー、IDサービス、DNS、またはサードパーティのWebhook | Herokuアプリはロードされるが、重要なワークフローが失敗する | アプリ全体を移行する前に、依存関係の状態を確認してください。 |
コントロールプレーンやデプロイツールに問題が発生したからといって、実行中のすべての dyno がリクエストの処理を停止するとは限りません。Heroku のアプリケーションライフサイクルに関するドキュメントには、Web dyno は Heroku ルーターを介して HTTP トラフィックを受信し、ワーカー dyno はバックグラウンド ジョブを処理すると説明されています。影響を受けるコンポーネントがダッシュボード、CLI、またはデプロイ パスである場合、オペレーターが通常どおりデプロイ、スケーリング、ログの確認、または構成の変更ができない場合でも、既存の Web アプリケーションは応答し続ける可能性があります。
逆のケースも考えられます。ツールサービスは正常でも、アプリやルーティングの障害によって公開URLが利用できなくなる場合があります。そのため、ダッシュボードの表示が緑色であっても、あるいはダッシュボードへのログインが失敗しても、アプリケーションの状態が完全に正常であるとは限らないのです。
アプリのプロセスは実行されているものの、データベースやキューに問題がある場合、ユーザーは最新データのないページが表示されたり、フォーム送信が失敗したり、重複したように見える再試行が表示されたり、処理が遅延したりする可能性があります。読み取り専用ページは正常に表示されるかもしれませんが、チェックアウト、アカウントの変更、または注文処理は静かに遅延している場合があります。
データベースエラーが発生するたびにリトライ回数を増やすのは避けてください。リトライ回数が多すぎると負荷が増大し、サービス復旧時に重複作業が発生する可能性があります。リトライ回数を制限し、冪等性を維持することを優先してください。実行手順書で許可されている場合は、重要でないバッチ処理を一時停止し、完了した操作、失敗した操作、不明な操作を記録してください。
Herokuの障害によりGitプッシュ、Deployment API、ビルドインフラストラクチャ、またはログに影響が出ている場合、開発者はリリースが本番環境に到達したかどうかを証明できない可能性があります。同じデプロイを再実行すると、混乱が生じたり、照合が困難な複数のリリースが生成されたりする可能性があります。コミット識別子、リリース番号(利用可能な場合)、ローカルコマンドの出力、およびタイムスタンプをキャプチャしてください。公式の復旧シグナルを待ってから、制御された検証デプロイを試みてください。
Salesforce関連のインシデントが発生しても、必ずしもHerokuアプリをホストするWeb dynoが停止するわけではありません。しかし、Salesforce認証、API呼び出し、Heroku Connect同期、またはイベント駆動型ワークフローに依存するアプリケーションは、重大な影響を受ける可能性があります。「Herokuはダウンしているのか?」という単純な問いではなく、「どのユーザー操作がどのサービスに依存しているのか、そしてどのデータを安全に延期できるのか?」という問いが重要です。
最適な応答アーキテクチャは一つとして存在しません。適切な投資は、ダウンタイムのコスト、データの耐久性要件、そしてチームが対応できる運用上の複雑さのレベルによって異なります。
| 必要 | 合理的なアプローチ | 受け入れるためのトレードオフ |
|---|---|---|
| 低コストの社内アプリ | 外部稼働状況チェック、文書化された復旧手順書、およびテスト済みのバックアップ | 回復は手作業で、時間がかかる場合がある |
| 顧客向けアプリケーションで、ダウンタイム許容度は中程度 | 独立した監視、段階的な機能低下、制限付きキュー、そしてスムーズな再デプロイパス | エンジニアリング作業が増え、維持管理すべきシステムも増える。 |
| 重要な収益または安全ワークフロー | 別個に運用されるフェイルオーバー環境、複製されたデータ戦略、およびリハーサル済みの切り替え | コスト増、一貫性の問題、そしてより困難な運用モデル |
| 移行を検討しているチーム | 移行する前に、インシデント履歴、サポートニーズ、移植性、復旧目標、および統合依存関係を比較してください。 | 移行によって新たな障害モードが発生する可能性があり、依存関係のリスクは解消されない。 |
複数リージョンまたは複数プロバイダーによるフェイルオーバーは、個別にテストされた場合にのみ有効です。同じIDプロバイダー、DNS、データストア、シークレット、またはデプロイメントパイプラインを共有するスタンバイ環境は、プライマリ環境と同時に障害が発生する可能性があります。逆に、外部監視が適切に行われ、明確な劣化モードを備えたシンプルなHerokuデプロイメントは、2つのプラットフォームを運用できない小規模チームにとって、より信頼性の高い選択肢となるでしょう。
持続的なエンジニアリングモデルは、既存アプリの直接的な動作を変えるというよりも、プラットフォームの進化に関する期待値を大きく変えるものです。Herokuは、安定性、安全性、信頼性を重視した運用とサポートに注力しており、新たな取り組みは持続的な目標に沿ったものであると述べています。既に本番環境でアプリケーションを運用しているチームにとって、顧客向けのメッセージは継続性です。コア機能は引き続き利用可能であり、クレジットカード利用者はこの発表によって日々の利用方法を変更する必要はありません。
トレードオフは戦略的なものです。幅広い新しいプラットフォーム機能を迅速に導入するために Heroku を選択する組織は、ロードマップと契約オプションを慎重に検討する必要があります。管理されたデプロイメントエクスペリエンス、成熟したアプリの基本機能、インフラストラクチャ管理の削減を優先する組織は、安定性を重視したモデルを異なる視点で見るかもしれません。Heroku はまた、新規顧客に対して新しいエンタープライズ アカウント契約は提供されなくなり、既存のエンタープライズ サブスクリプションとサポートは有効で更新できると述べています。これは調達と将来のアーキテクチャの決定には重要ですが、障害や現在デプロイされているアプリケーションに対する自動的なリスクの証拠ではありません。
2026年9月16日に確認された最新の公式スナップショットでは、Herokuで発生しているインシデントは確認されておらず、Herokuの2026年の保守エンジニアリングに関する発表では、プラットフォームの継続的なサポートについて説明されています。ただし、障害が発生した場合、デプロイ済みのアプリケーションへの影響は、障害が発生したレイヤーによって異なります。アプリケーションは可用性に影響を与え、データは正確性とキューイングされた作業に影響を与え、ツールはデプロイと可観測性に影響を与え、Salesforceやサードパーティの依存関係は、アプリケーション自体はオンラインのままであっても、個々のジャーニーを中断させる可能性があります。
Salesforce Trustを主要なインシデントソースとして使用し、公開されているステータスAPIと比較し、ネットワーク外部から実際のユーザーパスをテストし、アクションを実行する前に依存関係を分類してください。復旧目標に応じて、フェイルオーバー、グレースフルデグラデーション、または待機検証の応答を選択してください。Herokuのすべての障害に対して同じ対策が必要というわけではありません。
CCUS(二酸化炭素回収・利用・貯留)への投資は増加しているが、二酸化炭素回収は世界の排出量を逆転させることができるのだろうか?その有効性、規模拡大の制約要因、そして重要な証拠について見ていこう。
デジタルサプライチェーン、ロジスティクス、アナリティクス、グローバル貿易、オペレーションに関する7つのグローバルプログラムを比較し、最適なプログラムを選択するための実践的なガイダンスを提供します。
脳コンピューターインターフェースが神経信号をどのように解読してコミュニケーションと運動機能を回復させるのか、最近の研究で何が達成されたのか、そしてBCIの利用を依然として制限している要因は何かを学びましょう。
See how commercial drones combine sensors, edge AI, batteries, communications, and flight-control software—and where autonomy still depends on mission and regulation.
Compare seven strong battery and energy storage master's options by materials, systems, research, industry exposure, flexibility, language, and cost trade-offs.
ペイロード質量、バッテリー制限、天候、推進効率、機体構造が産業用UAVの航続時間にどのように影響するか、そしてそれを改善する方法を学びましょう。
スマート医療機器向けの主要な生物医学工学プログラムを比較検討しましょう。プログラムには、設計、バイオエレクトロニクス、AI、サイバーセキュリティ、臨床研修、規制などが含まれます。
明確な優先順位、代替ワークフロー、復旧チェック、テスト基準、および現実的な制限事項を盛り込んだ、実用的なSalesforceダウンタイム継続計画を策定してください。
StoreForceに問題が発生すると、スケジュール管理、勤怠管理、シフト変更、店舗内コミュニケーションに支障をきたす可能性があります。問題の診断方法、小売業務の円滑な運営、復旧状況の確認方法を学びましょう。
大規模なシステム障害発生時にSalesforceサポートに連絡する方法、適切なチャネルの選択方法、役立つケースの準備方法、重複チケットを作成せずにフォローアップする方法を学びましょう。








