Collabora OnlineとONLYOFFICEの比較:RAMと編集遅延の測定

Collabora OnlineとONLYOFFICE Docsを同一サーバー上で、メモリ使用量、ドキュメントのオープン時間、共同編集の遅延について、再現可能なテストを用いて比較します。
クラウドプラットフォームの大規模なダウンタイムは、単一のサーバーが単に「ダウンした」ことが原因であることはほとんどありません。最も深刻な障害は通常、設定ミス、ソフトウェアの欠陥、DNSの問題、ネットワーク障害、インフラストラクチャの不具合といった単一の技術的な問題から始まり、多くのサービスが同じ制御プレーン、データベース、IDシステム、ロードバランサー、またはリージョンリソースに依存しているために、その影響が拡大していきます。
具体例として、 Northstar Cloudという架空のクラウドプロバイダーを想像してみてください。午前10時5分、リージョンサービスに自動ネットワーク変更が適用されます。数分以内に、顧客からAPI呼び出しの失敗が報告され始めます。10時12分には、新しい仮想マシンの起動が停止します。10時20分には、ロードバランサーが正常なバックエンドを利用不可とマークし始めます。10時35分までに、一見無関係に見える数十もの製品が劣化します。このシナリオは架空のものであり、実際の障害を説明するものではありません。しかし、小さな初期障害が大規模なプラットフォーム障害に発展する理由を示す上で役立ちます。
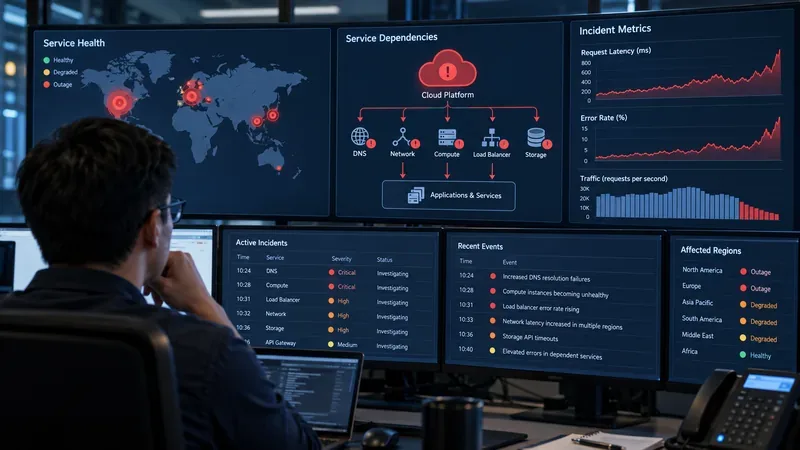
クラウドプラットフォームの広範なダウンタイムの主な原因は、設定やデプロイのミス、潜在的なソフトウェアの欠陥、DNSやルーティングの障害、共有サービスの依存関係、障害発生時や復旧時の容量不足、コントロールプレーンの問題、データセンターやアベイラビリティゾーンに影響を与える物理的な障害などです。障害の規模は、最初のエラーそのものよりも、影響を受けるコンポーネントがどれだけ広く共有されているかに大きく左右されます。
実例として、AWS の事例が挙げられます。AWS は、2025 年 10 月に北バージニアで発生した障害に関する公式事後報告の中で、DynamoDB の自動 DNS 管理システムに潜在的な競合状態が存在し、リージョンエンドポイントに対して誤った空の DNS レコードが生成されたと述べています。この DNS 障害は、DynamoDB に依存する顧客および AWS 内部サービスに影響を与え、その後の復旧作業は EC2 の起動やネットワークロードバランサーに関する問題を引き起こしました。このインシデントについては、AWS の 2025 年 10 月 DynamoDB 障害事後報告に記載されています。
現代のプラットフォームは自動化によって制御されているため、設定エラーは大規模分散システムにおけるインシデントで最もよく見られるパターンの一つです。単一の変更が、人間のオペレーターが手動で操作するよりもはるかに速く、数千ものホスト、ルーター、DNSレコード、またはサービスエンドポイントに反映されてしまうからです。
Northstar Cloudのシナリオに戻りましょう。10時05分のネットワーク変更は10台のマシンを対象とする予定でしたが、複数のリージョンに適用されてしまいました。この変更はハードウェアを破壊する必要はありません。単に使用可能なネットワーク容量を削減したり、ルーティングを変更したり、システムが本来正常なトラフィックを拒否したりするだけです。共有容量が需要を下回ると、顧客はタイムアウトや再試行が発生し、さらに負荷が増大します。
Googleは、2019年の障害に関する公式報告の中で、同様のメカニズムについて説明しています。あるリージョン内の少数のサーバーを対象とした設定変更が誤って広範囲に適用され、複数のリージョンで利用可能なネットワーク容量の半分以上が使用できなくなった結果、残りの容量がトラフィックで混雑したというものです。詳しくは、Googleの2019年のサービス障害に関する公式アップデートをご覧ください。
そのため、成熟したクラウド事業者は、段階的なロールアウト、検証、自動ロールバック、変更頻度制限、および「影響範囲」制御といった対策を採用しています。これらの対策によってインシデントを完全に排除することはできませんが、一つの不適切な変更がプラットフォーム全体に影響を及ぼす事態を防ぐことができます。
大規模なクラウドプラットフォームでは、膨大な数の分散ソフトウェアが稼働しています。一部の不具合は、2つのコントローラーが同じ状態を更新する、異常な遅延が発生する、メタデータが古い、または復旧プロセスとクリーンアッププロセスが同時に実行されるなど、まれな一連の事象が発生する必要があるため、数ヶ月または数年間も放置されたままになることがあります。
架空のノーススター事件を例にとると、2つの独立した自動化ワーカーが同じDNSプランを更新しようとします。一方のワーカーが遅延し、もう一方のワーカーが新しい更新を完了すると、クリーンアップルーチンが遅延したワーカーがアクティブにしたばかりのデータを削除します。個々のコンポーネントは設計どおりに機能しているように見えますが、それらの相互作用によって無効な状態が発生します。
2025年のAWS DynamoDBの障害は、このカテゴリーを明確に示しています。AWSは、この障害の原因を、冗長なDNS管理コンポーネント間の潜在的な競合状態にあるとしました。その重要性は、特定のベンダーに限ったものではありません。冗長性は、冗長コンポーネントが同じロジックや同期障害によって共有状態を破損させない場合にのみ、信頼性を向上させます。
サービスが完全に起動していても、顧客がホスト名を解決できなかったり、パケットが到達できなかったりすると、実質的に利用できなくなる可能性があります。そのため、DNS、ルーティング、ロードバランシング、ネットワーク構成は、ほぼすべてのクラウド製品においてクリティカルパス上に位置づけられます。
Northstarの例では、API呼び出しがタイムアウトしたため、顧客はコンピューティングサービス自体に障害が発生したと考えるかもしれません。しかし、実際にはコンピューティングサーバーは正常に動作しているにもかかわらず、DNSが使用可能なエンドポイントを返さなかったり、ルートが欠落していたり、ロードバランサーが正常なターゲットを削除していたりする可能性があります。
AWS は、この障害モードについて複数回報告しています。2018 年にソウルリージョンで発生したインシデントでは、設定の更新によって EC2 DNS リゾルバ フリートの正常ホストの最小数を指定する設定が誤って削除されたと AWS は述べています。その結果、リゾルバの容量が減少し、EC2 インスタンスからの DNS クエリが失敗するようになりました。詳細は、AWS が公開している「2018 年ソウルにおける EC2 DNS 解決問題の概要」をご覧ください。
ネットワーク障害は、アプリケーションが失敗した接続を再試行するため、急速に拡大する。積極的な再試行動作は、部分的なネットワーク障害をはるかに大きなトラフィックの急増へと発展させる可能性がある。
クラウドサービスは、独立した製品ではありません。マネージドデータベースは、IDサービス、内部DNS、ストレージ、ネットワーク、スケジューリングシステム、証明書サービス、テレメトリなどに依存する場合があります。サーバーレスプラットフォームは、コンピューティング能力、ネットワーク、キューイング、コントロールプレーンデータベースなどに依存する場合があります。共通の依存関係のいずれかに障害が発生すると、多くの製品が同時に機能低下を起こす可能性があります。
これは、最も紛らわしい障害症状の一つを説明するものです。顧客は複数のサービスでエラーが発生していることに気づき、それぞれ独立した障害が複数発生したと推測します。しかし実際には、目に見える障害はすべて同じ上流の要因によるものである可能性があります。
Northstarのシナリオでは、仮想マシンサービス、コンテナサービス、サーバーレスサービスはすべて同じ内部リソースデータベースに依存しているため、同時に障害が発生する可能性があります。顧客向けの製品はそれぞれ異なりますが、それらの基盤となる依存関係は同じです。
2025年10月に発生したAWSのインシデントでは、この種の連鎖的な影響が明らかになりました。DynamoDBに依存する内部サービスが当初のDNS問題の影響を受け、その後、EC2、ネットワークロードバランサー、Lambda、コンテナサービス、ID関連機能、その他の製品全体に復旧効果が波及しました。
障害が発生したコンポーネントを復元しても、必ずしも障害が解消されるとは限りません。ダウンタイム中は、キューが増大し、リース期間が満了し、ヘルスチェックが失敗し、オートスケーラーが代替容量を要求し、クライアントがリクエストを再試行し、構成更新が蓄積されます。障害が発生した依存関係が復旧すると、待機中のすべてのシステムが同時に復旧を試みる場合があります。
Northstarの例では、DNSが10時45分に修復されたとします。数千台のコンピューティングホストが、期限切れのリースを更新しようとします。同時に、顧客は失敗したデプロイメントを再試行し、オートスケーリングシステムは代替インスタンスを要求します。コントロールプレーンは、通常のワークロードの数倍の処理を突然行うことになります。効果的なレート制限やリカバリの優先順位付けがない場合、元のバグが解消されていても、コントロールプレーンは2度目の障害モードに陥る可能性があります。
AWSは2025年に同様の復旧問題が発生したと報告している。DynamoDBへのアクセスが復旧した後、EC2サブシステムが大量のリースを再確立する必要が生じた。タイムアウトが発生する前に処理しきれないほどのバックログが発生し、サブシステムは「輻輳崩壊」状態に陥ったという。この詳細は、障害発生期間が最初の原因の修復に必要な時間よりもはるかに長くなる可能性がある理由を示しているため、重要である。
ヘルスチェックは不可欠ですが、同時に自動的な意思決定機能も備えています。ネットワークの速度が低下したり、状態の伝播が遅れたりすると、ヘルスチェックシステムは正常なリソースを不良と判断し、サービスから除外してしまう可能性があります。これにより、さらに容量が低下し、悪循環が生じる恐れがあります。
この架空のシナリオでは、Northstarのロードバランサーが、ネットワーク構成が完全に伝播する前に、新しく起動されたインスタンスのチェックを開始します。チェックが失敗すると、正常なインスタンスは停止され、トラフィックは残りのノードに集中し、それらのノードは過負荷状態になります。
同様の現象は、2025年のAWSイベントでも発生しました。AWSによると、新規インスタンスのネットワーク状態がまだ伝播している最中に、ネットワークロードバランサーのヘルスチェックが失敗し、サービスからキャパシティが削除されることがあったとのことです。これは、フェイルオーバーロジックは、正常な「正常/異常」状態だけでなく、部分的な障害発生時にもレート制限とテストを実施する必要があることを改めて示しています。
すべての障害がソフトウェアに起因するわけではありません。電力、冷却システム、光ファイバー、ネットワーク機器、その他の物理インフラが故障する可能性があります。クラウドアーキテクチャはこうした現実を前提に設計されており、そのため主要なプロバイダーはリージョンを障害隔離ゾーンに分割しています。
Microsoft は、Azure 可用性ゾーンは、独立した電源、冷却、ネットワークを備えたデータセンターのグループであると説明しています。また、ゾーン展開はゾーン障害発生時に自動的に復旧するわけではないため、サポートされている場合は複数のゾーンまたはゾーン冗長サービスを使用する必要があると述べています。詳細については、Microsoft の公式 Azure 可用性ゾーンの概要をご覧ください。
実際には、クラウドプロバイダーはゾーンを独立させることができますが、顧客のワークロードは依然として単一ゾーンのデータベース、単一のリージョン制御への依存関係、または一度も実行されたことのないフェイルオーバープロセスを持つ可能性があります。
「グローバル障害」とは、多くの場合、障害が発生した機器の物理的な場所ではなく、顧客への影響度合いを表す表現です。地域サービスは、認証、DNS、メタデータ、ビルドパイプライン、ダッシュボード、または他の地域で使用される制御APIなどをサポートしている場合があります。そのため、世界中のアプリケーションは、1か所に集中したサービスに依存しているため、障害が発生する可能性があります。
インシデントを診断する際には、この区別が重要になります。エンジニアは、「最初の障害はどこで発生したか?」と「どの依存関係によってその障害が広がったか?」という2つの異なる質問を自問する必要があります。これらの答えは、多くの場合異なります。
運用担当者にとって、最も迅速な解決策は、個々の製品を個別に調査するよりも、症状を関連付けることです。多くのサービスが同時に障害を起こした場合は、共通の依存関係を探してください。既存のワークロードは正常に動作しているのに、新規デプロイメントが失敗する場合は、コントロールプレーン、スケジューリング、キャパシティ、またはプロビジョニングの問題が疑われます。IP接続は機能しているのにサービス名が機能しない場合は、DNSを調査してください。復旧アナウンス後にエラー率が上昇した場合は、リトライの集中、バックログ、期限切れのリース、ヘルスチェックのフィードバックループ、または復旧キャパシティの不足を探してください。
プロバイダーのステータスシステムは、プラットフォームの障害とアプリケーション固有の障害を区別するのにも役立ちます。たとえば、Google Cloud は公式のサービスヘルスダッシュボードを通じて現在および過去のインシデントを公開しており、AWS は公式のイベント後サマリーを通じて主要なイベントの概要を公開しています。
ダウンタイムゼロを保証するアーキテクチャは存在しませんが、いくつかの設計上の選択肢によってリスクを軽減できます。サービスが対応している場合は、本番ワークロードに複数の可用性ゾーンを使用してください。リージョン全体の障害を許容できないワークロードについては、マルチリージョン設計を評価し、データの一貫性に関するトレードオフを理解してください。すべての復旧アクションが依存する単一のリージョンIDサービス、単一のDNSパス、または単一の管理APIなど、隠れた単一障害点を排除してください。
アプリケーションは、障害発生時に適切に処理を完了できるようにする必要があります。そのためには、キャッシュされたコンテンツを提供したり、重要度の低い書き込みをキューに入れたり、指数バックオフとジッターを使用して再試行を制限したり、制御プレーン操作とデータプレーンのトラフィックを分離したり、部分的な障害発生時に「読み取り専用」または「コアトランザクション」モードを維持したりすることが考えられます。復旧手順は、バックログが発生した状況でテストする必要があります。なぜなら、空のテスト環境で依存関係を再起動することと、数百万件のリクエストが待機している状況で依存関係を復元することは全く異なるからです。
Northstar Cloudのシナリオに戻りましょう。10時05分の構成変更が引き金になった可能性はありますが、それだけが原因ではありません。ネットワークが共有されていること、自動化にタイミングの欠陥があること、下流のサービスが同じ状態に依存していること、ヘルスチェックによって容量が消費されること、再試行によって負荷が増加すること、そして復旧システムが膨大なバックログを処理しなければならないことなどが原因で、障害が広範囲に及ぶのです。
これは、多くの大規模なクラウド障害の背後にある中心的なパターンです。つまり、最初の障害自体は小さいものの、それを増幅させる依存関係の連鎖が大きな問題となることが多いのです。したがって、クラウドのダウンタイムを理解するには、根本原因と伝播の両方を検証する必要があります。最も堅牢な設計では、個々のコンポーネントが障害を起こすことを前提とし、それらの障害がシステム全体に影響を及ぼす事態を防ぐことに重点を置いています。
Collabora OnlineとONLYOFFICE Docsを同一サーバー上で、メモリ使用量、ドキュメントのオープン時間、共同編集の遅延について、再現可能なテストを用いて比較します。
ONLYOFFICE DocsとMicrosoft 365のWebアプリにおける文書、スプレッドシート、レイアウトの動作を比較し、簡単なテストでファイルに適した安全なエディターを選択してください。
数式の不一致の原因を構文、地域区切り文字、再計算、日付システム、またはサポートされていない関数に絞り込み、ワークブックを共有する前に検証してください。
最新リリースのデータから何が証明でき、何が証明できないかを確認し、同じファイルとコンピューター上で両方のオフィススイートを比較してください。
完全一致、左辺参照、欠損値処理、バージョンサポートなどを比較して、信頼性の高いCalcの数式を選択してください。
WriterのページスタイルとWordのセクションリンクが、ドキュメントを移動したときに表紙、ローマ数字、および番号の再開にどのように影響するかを学びましょう。
Pardus Software CenterとAPTコマンドを比較して、タスクに適した方法でパッケージの検索、インストール、削除、更新を行ってください。
Pardusが公表しているRAM要件が何を意味するのかを確認し、同じPC上で再現性のあるMemAvailable値を用いてXFCEとGNOMEを比較してください。
HamoniKR 8.0がビジネス向けデスクトッププランの中でどのような位置づけになるのか、韓国語に特化した機能がどのようなサポートを提供しているのか、そして本格的な展開前に確認すべき事項について見ていきましょう。
Gooroomの起動検証と実行時保護がどのように連携しているのか、「サンドボックス」とは何を意味するのか、そしてデバイス上でどの設定を確認すべきかを理解しましょう。






