2026年のテクノロジーを活用した高齢者介護:AIとスマートホームが在宅介護にできること、できないこと

AI、スマートホームセンサー、遠隔監視、転倒防止、プライバシー、そして介護を代替することなくテクノロジーが高齢者の在宅介護をどのように支援できるかについて、2026年版の実践ガイド。
次世代のAIおよびスーパーコンピューティングハードウェアは、単一の画期的な技術によって支えられているわけではありません。ゲートオールアラウンドトランジスタ、バックサイド電源供給、チップレットアーキテクチャ、高度なパッケージング、高帯域幅メモリ、高速なダイ間リンク、そしてますます普及が進む光ネットワークなど、複数の技術が連携して動作することで構築されています。その結果、トランジスタの小型化だけに頼ることなく、より高い演算能力、より広いメモリ帯域幅、そしてより優れたスケーリングを実現できるのです。
これは重要な点です。なぜなら、最新のAIアクセラレータや科学用スーパーコンピュータは、演算能力が限界に達する前に、データ転送速度や電力消費の限界に直面することが多いからです。行列演算エンジンの高速化は、モデルの重み、活性化関数、中間結果が十分な速さで処理できる場合にのみ有効です。同様に、アクセラレータの増設も、パッケージ、ラックネットワーク、メモリシステム、冷却システム、ソフトウェアスタックがそれらを十分に活用できる場合にのみ有効です。
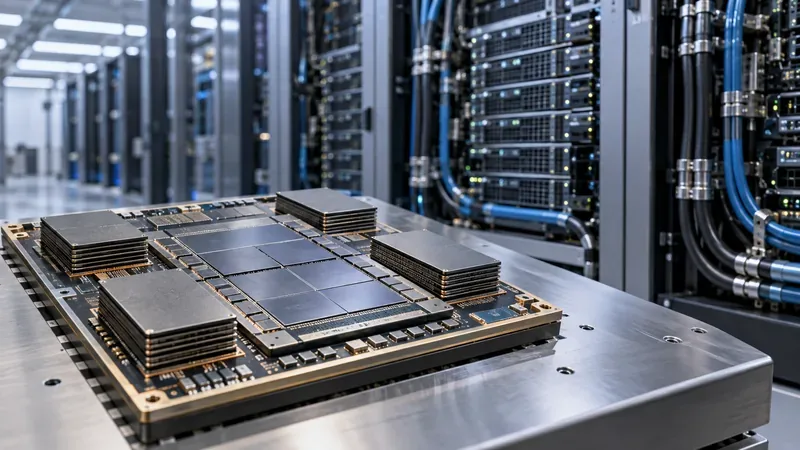
最先端のロジック回路は、長年にわたり先進チップを支配してきたFinFET構造から脱却しつつあります。ゲートオールアラウンド(GAA)設計では、ゲートをナノシートや同様のチャネル構造の周囲に巻き付けることで、微細化が進むにつれてチップ設計者はより厳密な静電制御が可能になります。これにより、性能の向上、リーク電流の低減、あるいは両者のバランスの最適化が実現できます。
TSMCは、2ナノメートルN2プロセスが2025年第4四半期に量産を開始したと発表しました。一方、同社のA16テクノロジーは、ナノシートトランジスタと背面電源レールを組み合わせたもので、特に高密度な電力供給を必要とする高性能コンピューティング製品を対象としています。TSMCは、A16の量産開始を2026年後半に予定していると述べています。詳細は、同社のA16テクノロジーページおよび2025年年次報告書をご覧ください。
Intelは、Intel 18Aで同様の方向性を踏襲しています。このプロセスは、RibbonFET GAAトランジスタとPowerViaバックサイド電源供給を組み合わせています。Intelは、18Aが2025年に量産開始され、強化版の18A-Pが2026年6月にリスク生産開始されたと報告しています。Intelはまた、このノードの性能、消費電力、密度に関する比較データも公開しています。これらの数値はベンダーが報告したものであり、普遍的なチップレベルの性能向上として扱うのではなく、特定の設計に対して検証する必要があります。最新の詳細は、Intelの18Aプロセスページに掲載されています。
高度なチップは、信号と電力の両方を極めて高密度な配線を通して伝送する必要があるため、背面電源は重要です。電力供給ネットワークの一部を背面側に移動することで、信号側の配線リソースを解放し、電圧供給を改善できます。多数の演算ユニットが高速でスイッチングするAIアクセラレータにおいては、これはトランジスタ密度と同様に重要となる可能性があります。
モノリシックダイは、規模が大きくなるにつれて、スケーリングが難しくなり、コストも高くなります。チップレットは別の道筋を示します。個々の機能をそれぞれに最適なプロセス技術で製造し、1つのパッケージ内で接続することができます。演算ダイには最先端のロジックプロセスが必要になるかもしれませんが、I/O、キャッシュ、アナログ回路、その他の機能には必要ないかもしれません。
パッケージングこそが、この技術を実用化する鍵となる。例えば、TSMCの先進的なパッケージングプラットフォーム「CoWoS」は、複数のロジックデバイスと高帯域幅メモリのスタックを2.5Dパッケージに統合するように設計されている。TSMCは特に、演算装置とHBM間の短く広い接続が重要なAIおよびHPC製品向けにCoWoSを位置付けている。
チップレットの独自性を低減するための標準規格も登場しつつある。 2025年8月にリリースされたUCIe 3.0仕様は、48 GT/sと64 GT/sのデータレートをサポートし、電力効率、管理性、およびより柔軟なマルチチップシステムのための機能を追加している。UCIeによってチップレットがすぐに互換性を持つようになるわけではないが、パッケージ内リンクのための共通の電気的およびプロトコルフレームワークを業界に提供する。
このアプローチは、企業が再利用可能な構成要素から複数のアクセラレータバリアントを構築したい場合に特に魅力的です。しかし、パッケージコスト、熱密度、設計の複雑さがモジュール化のメリットを上回る場合は、魅力は低下します。メモリとI/Oのニーズが控えめな小型製品であれば、よりシンプルなモノリシックデバイスの方が適している場合もあります。
AIワークロードでは、メモリと演算ユニット間で大きなテンソルが繰り返し移動します。そのため、メモリ帯域幅は設計上の最重要制約となります。高帯域幅メモリ(HBM)は、DRAMダイを積層し、非常に広いインターフェースを介してアクセラレータに物理的に近接させることで、この問題を解決します。
HBM4は、ロードマップ上の構想段階から商用システムへと移行しつつあります。サムスンは2026年2月にHBM4の商用出荷を発表し、持続転送速度11.7Gb/s、最大転送速度13Gb/sで量産体制に入ったと発表しました。また、2026年5月にはHBM4Eのサンプル出荷も発表しています。これらの詳細は、サムスンのHBM4生産発表資料で確認できます。
SKハイニックスは2026年第2四半期決算報告で、同四半期中にHBM4の量産出荷を開始し、下半期には生産を本格化させる計画だと発表した。同社は12層HBM4Eのサンプル出荷も完了している。最新の状況については、SKハイニックスの2026年第2四半期決算報告を参照のこと。
実際にはなぜこれが重要なのでしょうか?NVIDIAの現在のVera Rubinの仕様では、1つのRubin GPUに288 GBのHBM4が搭載され、GPUメモリ帯域幅は19.2 TB/sとなっています。これに対し、AMDのMI350シリーズアクセラレータはHBM3Eを使用しており、AMDはMI355Xで最大288 GB、8 TB/sの帯域幅を謳っています。これらは異なるアーキテクチャであり、帯域幅の数値だけで比較すべきではありませんが、どちらもメモリ容量と帯域幅が二次的な詳細ではなく、アクセラレータのコア仕様になっていることを示しています。NVIDIA Vera Rubin NVL72の公式仕様とAMD Instinct MI350シリーズのページを参照してください。
大規模なモデルや科学シミュレーションは、単一のデバイスに収まることはほとんどない。システムは複数のアクセラレータに処理を分散させ、部分的な結果を頻繁に交換する必要がある。通信速度が遅いと、高価な計算ユニットが遊休状態になる。
そのため、独自のスケールアップファブリックはGPU自体と並行して進化を続けています。NVIDIAのRubinプラットフォームは第6世代NVLinkを採用しており、NVIDIAはRubin GPUあたり3TB/s、NVL72システム全体で216TB/sのNVLink帯域幅を実現しています。AMDはアクセラレータプラットフォーム全体でInfinity Fabricを使用しています。購入者にとって重要なのは、ピーク時のリンク帯域幅だけでなく、アプリケーションで使用される正確な集合演算、モデル並列パターン、トポロジーの下でファブリックがどのように動作するかです。
システムメモリレベルにおいても、Compute Express Link(CXL)は進化を続けています。CXLコンソーシアムによると、CXL 4.0では信号伝送速度が64 GT/sから128 GT/sへと倍増し、バンドルポートが追加され、メモリの信頼性機能が拡張されています。CXLは、各メモリ階層をリモートストレージデバイスとして扱うことなく、一貫性のあるメモリ拡張、プーリング、または分離を実現したい場合に有効です。
銅線は短距離で高密度な電気接続には依然として最適ですが、距離と総帯域幅が増加するにつれて、光リンクの魅力はますます高まります。次の大きなステップは、光コンポーネントをスイッチのエッジにあるプラグイン式トランシーバーに完全に収めるのではなく、ネットワークASICにより近い場所に配置した、コパッケージ型光コンポーネントです。
NVIDIAは、同社のSpectrum-X Ethernet Photonicsプラットフォームがコパッケージ化された光モジュールを採用しており、従来のプラグイン式トランシーバー設計に比べて最大5倍優れたネットワーク電力効率を実現していると述べています。これはベンダー間の比較であり、すべてのデータセンター構成で保証されるものではありませんが、今後の方向性を示しています。ネットワーク電力は、光統合が半導体システム設計の一部となるほど重要な要素になりつつあります。NVIDIAのシリコンフォトニクス概要をご覧ください。
| 作業負荷 | 優先すべき半導体機能 | なぜそれらが重要なのか |
|---|---|---|
| 大規模モデルの事前学習 | HBMの容量と帯域幅、高速スケールアップリンク、高密度パッケージング、強力な冷却 | トレーニングでは、テンソルの移動と、多数のアクセラレータ間での同期通信に多くの時間が費やされます。 |
| 長期的文脈と主体性推論 | 大規模HBMプール、効率的な低精度演算、高帯域幅インターコネクト、メモリ階層化 | KVキャッシュと反復的な推論ステップは、ピークFLOPSよりもメモリ容量とデータ移動を制限要因にする可能性がある。 |
| 科学計算HPC | FP64機能、メモリ帯域幅、信頼性の高い相互接続、成熟した数値ライブラリ | シミュレーションコードは、低精度テンソルのスループットだけでなく、倍精度演算と持続的な帯域幅に依存することが多い。 |
| エンタープライズ推論 | ワットあたりの性能、ソフトウェアの互換性、適切なサイズのメモリ、PCIeの展開オプション | 最適なシステムは、最も高密度なラックアーキテクチャではなく、既存のサーバーと電力容量に適合するシステムである可能性がある。 |
| カスタムアクセラレータ | チップレット戦略、パッケージングエコシステム、UCIeサポート、プロセス成熟度 | モジュール化によって再利用サイクルを短縮できる可能性があるが、パッケージの複雑さやサプライチェーンの品質管理がその利点を相殺する可能性がある。 |
コンテキストウィンドウが長い大規模言語モデルを扱うチームを考えてみましょう。プロファイリングの結果、GPUがメモリ転送やGPU間通信で頻繁に待機していることが判明したとします。より新しいアクセラレータに移行すれば改善が見込めますが、そのためには新しいシステムが十分なHBM容量、より高速なメモリ帯域幅、そして通信の遅延を軽減するトポロジーを備えている必要があります。理論上のテンソル性能が向上したデバイスを購入しても、メモリやネットワークのボトルネックが変わらない場合は、謳い文句のスペックほどの改善は得られないかもしれません。
従来のスーパーコンピューティングにも同様の原理が見られます。オークリッジ国立研究所のFrontierシステムは、AMD MI250XアクセラレータとHBM、そして高速システムインターコネクトを組み合わせています。Frontierのユーザーガイドには、演算処理、HBM、CPU-GPUリンク、そしてSlingshotネットワークがどのように連携して動作するかが解説されています。ハードウェアの世代は2026年の最新AIプラットフォームよりも古いものですが、アーキテクチャ上の教訓は今もなお有効です。つまり、アプリケーションの持続的なパフォーマンスは、演算処理、メモリ、その他のノード間の経路に依存するということです。
アップグレードは、単に古い部品を交換するのではなく、測定可能なボトルネックを解消する場合に最も正当化されます。新しいアクセラレータ世代を導入する前に、以下の点を確認してください。
半導体技術の進歩は目覚ましい成果を上げているが、その限界要因もますます顕著になってきている。先進的なパッケージは大型化し、製造もより困難になっている。HBMスタックは高出力ロジックの近くに熱を集中させる。ラック規模のシステムでは、液冷、高密度な電力分配、特殊なネットワーク接続が必要となる場合がある。光学部品をパッケージ化することでネットワークの消費電力を削減できる一方で、新たな製造および保守上の課題が生じる。チップレットはモジュール性を向上させることができるが、検証、パッケージング、歩留まり管理といった作業が増える。
ソフトウェア面でもトレードオフが存在する。FP8、FP6、FP4といった低精度演算はAIのスループットを大幅に向上させるが、ソフトウェアはモデルの品質を維持しなければならない。科学計算コードでは、同じショートカットが使えない場合もある。半導体の機能は、アプリケーションスタックが精度や信頼性の要件を損なうことなくその機能を活用できる場合にのみ価値がある。
2026年の残りの期間から2027年にかけて、最も有用な指標は新しいノード名だけではありません。TSMCのA16プロセスとIntelの18Aファミリープロセスが幅広い顧客向け製品に導入されるかどうか、HBM4とHBM4Eがどれだけ早く大規模に利用可能になるか、UCIe 3.0が意味のあるマルチベンダーチップレットの相互運用性を実現するかどうか、CXL 4.0が生産システムにどのような形で登場するか、そしてコパッケージ化された光学部品が大規模展開において経済的かつ保守的に機能するかどうかに注目する必要があります。
これらの節目は、半導体業界が、メモリの移動、電力供給、ネットワーク、冷却といった要素によって、より高密度なロジックによって得られた利点が相殺されることなく、AIとスーパーコンピューティングの規模拡大を継続できるかどうかを示すものとなるだろう。
AIとスーパーコンピューティングの未来は、単一の「次世代ノード」ではなく、協調的な半導体エンジニアリングによって支えられつつあります。GAAトランジスタとバックサイド電源は、ロジック基盤を強化します。チップレットと高度なパッケージングにより、設計者は単一のダイでは実現できない規模のシステムを構築できます。HBM4は、極めて高い帯域幅でアクセラレータに電力を供給します。UCIe、CXL、NVLink、Infinity Fabric、および光ネットワークは、ますます広大なドメイン間でデータを転送します。
ハードウェアを選択する際は、ワークロードの真のボトルネックから始めましょう。メモリ負荷の高いAIの場合は、HBMの容量と帯域幅を優先します。分散トレーニングの場合は、スケールアップとスケールアウトのファブリックを優先します。科学計算の場合は、FP64とライブラリのパフォーマンスを確認します。エンタープライズ展開の場合は、電力、冷却、ソフトウェアサポート、統合作業も考慮に入れて決定します。理論上最速の半導体が、必ずしもワークロードにとって最速または最も経済的なシステムになるとは限りません。
AI、スマートホームセンサー、遠隔監視、転倒防止、プライバシー、そして介護を代替することなくテクノロジーが高齢者の在宅介護をどのように支援できるかについて、2026年版の実践ガイド。
都市が、人々の生活を最優先することなく、交通、土地利用、気候、地域社会に関するデータを活用して、より安全で環境に優しく、歩きやすい街づくりを実現する方法を学びましょう。
ドローン、自律システム、制御、UAS(無人航空機システム)の運用、大学院研究に関する主要なUAVおよび航空宇宙工学プログラムを比較し、2026年までの最新情報を検証します。
AI搭載型手術ロボットの実践ガイド:現在の機能、自律性のレベル、精度面での利点、限界、規制、評価基準。
CCUS(二酸化炭素回収・利用・貯留)への投資は増加しているが、二酸化炭素回収は世界の排出量を逆転させることができるのだろうか?その有効性、規模拡大の制約要因、そして重要な証拠について見ていこう。
デジタルサプライチェーン、ロジスティクス、アナリティクス、グローバル貿易、オペレーションに関する7つのグローバルプログラムを比較し、最適なプログラムを選択するための実践的なガイダンスを提供します。
脳コンピューターインターフェースが神経信号をどのように解読してコミュニケーションと運動機能を回復させるのか、最近の研究で何が達成されたのか、そしてBCIの利用を依然として制限している要因は何かを学びましょう。
See how commercial drones combine sensors, edge AI, batteries, communications, and flight-control software—and where autonomy still depends on mission and regulation.
Compare seven strong battery and energy storage master's options by materials, systems, research, industry exposure, flexibility, language, and cost trade-offs.
ペイロード質量、バッテリー制限、天候、推進効率、機体構造が産業用UAVの航続時間にどのように影響するか、そしてそれを改善する方法を学びましょう。








